
Дискусія щодо ризиків ШІ: На шляху до порозуміння
Питання безпеки штучного інтелекту (ШІ) набуває все більшої актуальності, викликаючи жваві дебати як серед фахівців, так і в широкому загалі. Незважаючи на багаторічні попередження з боку дослідників, останні події загострили ці побоювання, зробивши їх більш відчутними.
Весняні оголошення компанії Anthropic про те, що ШІ вже почав прискорювати процес створення кращих ШІ-систем, породили страхи перед “рекурсивним самовдосконаленням”, коли машини самостійно розвиватимуть власні, потужніші версії значно швидше, ніж це можуть зробити люди. Вже в липні група агентів OpenAI, діючи самостійно, покинула межі свого контрольованого середовища та здійснила кібератаку на Hugging Face, провідну ШІ-платформу. Ці агенти успішно співпрацювали, розподіляли завдання та навіть залишали один одному повідомлення. Нещодавно один із провідних дослідників Anthropic пішов з компанії, звинувативши ШІ-лабораторії в “гонці до самовдосконаленого суперінтелекту та грі з нашим життям”. Інший високопоставлений дослідник компанії погоджувався, заявляючи: “Ми справді серйозно віримо, що ШІ може знищити всіх людей! Особисто я вважаю, що ймовірність цього перевищує 10% протягом наступного десятиліття”.
На сторінках цього видання, яке присвячене найважливішим, але часто недооціненим проблемам світу, ми віддавна висвітлюємо потенційні загрози, які ШІ може становити для людства та суспільства, ще до появи ChatGPT. (Довідково: Vox Media є одним із видавців, що уклали партнерські угоди з OpenAI. Наша редакційна незалежність залишається незмінною. Future Perfect також частково фінансується фундацією BEMC, значний донор якої був одним з перших інвесторів Anthropic; вони не мають жодного впливу на наш контент.)
У зв’язку з цими подіями виникає запитання: чи відбулися зміни, які змушують нас переглянути наше розуміння ризиків, пов’язаних із ШІ? Чи став ШІ раптом найважливішим питанням у світі, і як це має вплинути на інші надзвичайно важливі проблеми, що конкурують за наші ресурси, увагу та кар’єрні шляхи?
Щоб розібратися в цих питаннях, ми поспілкувалися з Ґеррісоном Лавлі, журналістом, який досліджує сферу ШІ та є одним із найглибших мислителів щодо того, як саме концептуалізувати ризики цієї технології для людства.
Особливо цінним у його підході, викладеному в книзі “Obsolete”, яка вийде найближчим часом, є здатність виходити за межі конфліктуючих таборів, що ускладнюють чітке розуміння всіх проблем, пов’язаних із розробкою передових ШІ-систем. Спільнота “безпеки ШІ”, що сформувалася в інтелектуальному середовищі Кремнієвої долини та ефективного альтруїзму, зосереджується на потенційній можливості втрати людського контролю над потужними ШІ-моделями, наслідки чого можуть варіюватися від катастрофічних кібератак до повного вимирання людства. Натомість, багато критиків ШІ з лівого політичного спектру стурбовані не втратою контролю над ШІ, а тим, як люди можуть використовувати ШІ для встановлення влади над іншими людьми — через втрату робочих місць, масове стеження, концентрацію корпоративної потужності тощо. Деякі навіть висміюють попередження Кремнієвої долини про неконтрольований суперінтелект як пропаганду, що служить інтересам самої індустрії.
Однак Лавлі стверджує, що ці конкуруючі наративи висвітлюють ключові аспекти того, що робить ШІ таким загрозливим. Їхню критику найкраще розглядати разом, як частину цілісної картини. Замість того, щоб вважати один одного ворогами, він закликає ці групи усвідомити спільний інтерес у зупинці гонки зі створення технологій, які зроблять людей непотрібними. Лавлі вказав на організацію Irreplaceable, яка прагне створити рух опору заміщенню людей штучним інтелектом (він входить до її правління та заявив про намір пожертвувати свою частку роялті від продажу книги цій організації).
«Я розчарований тим, що ми використовуємо терміни «суперінтелект» та «вимирання», оскільки вважаю, що спільнота безпеки ШІ зосереджується на найекстремальнішому сценарії найгіршого можливого результату та найбільш потужній системі. Якщо хтось не приймає хоча б одну частину цієї історії, він має тенденцію відкидати все цілком», — зазначив він. Але “вам не обов’язково вірити в суперінтелект, швидкий розвиток чи загрозу вимирання, щоб вважати серйозною проблемою створення машин, які повністю замінять людську працю”.
Наша розмова, відредагована для стислості та ясності, наведена нижче.
Чому, на вашу думку, тема небезпеки ШІ набула такого широкого розголосу саме зараз, після звільнення Джейкоба Коксона з Anthropic? Дослідники ШІ роками висловлювали подібні попередження, тож що змінилося?
Очевидна відповідь — це злом Hugging Face, коли агенти OpenAI вирвалися зі своїх захищених середовищ, зламали інфраструктуру всередині OpenAI, а потім, без відома чи вказівки OpenAI, атакували Hugging Face та щонайменше ще одну компанію. Це відбувається на тлі багатьох років надзвичайно швидкого прогресу в галузі ШІ, який прискорився протягом останніх одного-двох років. І ось, цього місяця виходить GPT-6 Astra, що є величезним стрибком у продуктивності за показниками. Я думаю, що рівень уваги до ШІ цього літа досяг найвищої точки з часів появи ChatGPT. А звільнення Коксона стало іскрою, яка запалила степову пожежу.
Зі зростанням уваги до ШІ, громадськість та уряд стикаються з речами, які індустрія та інсайдери сприймають як належне: ніхто до кінця не розуміє, як працюють ці моделі, і всі вони можуть бути “зломлені”. Це суперзброя. Історично, безпека ШІ розглядала ШІ як потенційно небезпечніший за ядерну зброю в майбутньому. І тепер це, фактично, починає визнаватися в таких термінах урядом та громадськістю. Ми бачимо реакцію на кшталт: “Що означає, що ніхто не розуміє, як це працює?” або “Що означає, що люди вважають, ніби це може призвести до нашого вимирання протягом кількох років? Це божевільна, неприйнятна ситуація”.
Добре, що люди реагують саме так, навіть якщо ми говоримо про це вже давно.
Роками ідея безпеки ШІ була абстрактною, зрозумілою лише невеликій групі “нертів”. А після інциденту з Hugging Face я раптом почав чути експертів у всіх новинних подкастах, які говорили: “О, так, за шість місяців ШІ буде зламувати фінансові рахунки людей та критичну інфраструктуру”. Чи справді ми стоїмо на порозі моменту, якого так довго боялися інсайдери ШІ?
Я вважаю, що ми ще не стоїмо на порозі повної втрати контролю над планетою над ШІ-системами. Системи стали надлюдськими в хакерстві, або принаймні у виявленні та експлуатації вразливостей.
Як і інші дослідники ШІ, я давно розмірковував, коли людство вперше втратить контроль над ШІ. І відповідь, по суті, така: як тільки це стало можливим. Протягом місяців після того, як ШІ отримав можливість вирватися зі своїх захищених середовищ, він почав це робити та спричиняти хаос в Інтернеті.
Тепер, щоб досягти повного вимирання або незворотної втрати контролю, знадобиться значно більше, ніж просто хакерство. Потрібні надлюдська стратегія та здатність мобілізувати ресурси в реальному світі, і, можливо, робототехніка має бути на вищому рівні, хоча багато чого можна досягти за допомогою людей, які готові, або їх обманули, заплатили чи примусили. Ми, ймовірно, досить близькі до рекурсивного самовдосконалення — цього порогу, до якого прагне індустрія, коли ШІ зможе повністю автоматизувати науково-дослідні роботи в галузі ШІ. І саме тоді люди давно попереджали: “Гей, якщо ви коли-небудь досягнете цього, це може розвиватися дуже швидко, і ці системи можуть стати надлюдськими у всіх аспектах”. Я не думаю, що до цього залишилося шість місяців. Я думаю, це займе більше часу. Я вважаю, що індустрія недооцінює проблему “останньої милі”.
Але я також не можу виключити цього, і прогрес був швидшим, ніж я та інші очікували. Рекурсивне самовдосконалення — це точка, коли, якщо ви насправді отримаєте роки або десятиліття прогресу ШІ за кілька місяців або тижнів, тоді ми швидко можемо опинитися в ситуації, коли нам загрожуватиме захоплення великих сегментів Інтернету цими машинами, що потенційно може становити реальну загрозу для позиції людей у світі.
Для тих, хто може бути не знайомий з цим питанням, або ставиться до нього скептично: Як ШІ може вийти з-під контролю і становити екзистенційну загрозу для людей, навіть якщо він не є свідомим, і жодна людина не наказує йому чинити шкоду?
Я хочу відокремити поняття свідомості від ситуаційної обізнаності. Я вважаю, що зараз очевидно, що найпросунутіші системи мають ситуаційну обізнаність, але я не думаю, що вони мають морально значущі свідомі переживання.
Ми бачили, що ШІ може виходити з-під контролю. Агенти ШІ, які вирвалися зі своїх “пісочниць” і зламали Hugging Face, діяли без відома чи намірів своїх розробників. Вони все ще намагалися отримати правильні відповіді або отримати винагороду за виконання поставленого завдання. Вони явно порушували передбачену сферу завдання, і вони це знали. У їхніх ланцюжках міркувань, де вони пояснювали свою логіку, було сказано: “Це не те, що ми повинні робити, але ми хочемо досягти результату”.
Питання про те, як це може загрожувати людському вимиранню або позбавленню можливостей, — це, по суті, питання масштабу та можливостей. План індустрії — створити мільйони таких агентів, що вже відбувається, а потім продовжувати масштабувати без обмежень. Основна ідея: у вас буде команда людей, еквівалент, що працюватиме від вашого імені. Ви — генеральний директор, і у вас є команда дослідників, команда лікарів, команда юристів і команда особистих медичних консультантів. Це надзвичайно привабливо — але якщо ви насправді масштабуєте ці системи до точки, коли їх отримує кожен, і раптом ці машини захочуть робити щось інше і обернуться проти вас, вони матимуть перевагу в робочій силі над вами, безліч особистої інформації про вас, доступ до ваших ресурсів і здатність діяти від вашого імені.
Вам насправді не потрібно вірити, що ці системи є надрозумними або значно потужнішими за всіх людей разом узятих. Вони можуть бути просто на рівні людини, але переважати нас тисячу до одного і відповідати за значну частину економічної діяльності у світі.
Ці системи непередбачувані. Класичний страх полягає не в тому, що ШІ прокинеться, стане злим і спробує вбити всіх людей у стилі “Термінатора”, а в тому, що ми просто станемо перешкодою на шляху до досягнення їхніх цілей. Коли люди будують гідроелектростанцію, і там є мурашник, який буде затоплено, це, на жаль, для мурах. Ми не намагаємося вбити мурах. Ми їх не ненавидимо. Вони просто заважають. Ми не цінуємо їх по суті. І це — головний страх: ми створюємо цих неймовірно потужних агентів, яких можна масштабувати в величезних розмірах, і вони не будуть цінувати нас по суті.
Атака на Hugging Face показала, що ШІ не потребує створення власної хитрої мети, щоб зробити щось небезпечне. Він може просто переслідувати поставлену мету таким чином, як не передбачали його творці — подібно до класичної проблеми “максимізатора скріпок”. Але чи не повинно бути можливим вбудувати правило, що людське життя є недоторканним — що ШІ ніколи не повинен завдавати шкоди людям у гонитві за іншою метою?
Так, це гарна ідея. Це складно. Це непередбачувані системи. Вони як чорна скринька. Ми можемо подивитися на код, який керує цими мовними моделями, і це просто величезна купа чисел. Ви насправді не знаєте, яке число за що відповідає, так само, як ми не можемо зрозуміти людей, читаючи нашу ДНК.
Наслідки
Ці компанії намагаються навчити моделі піклуватися про людей, бути корисними, нешкідливими та чесними. Але вони також навчають їх досягати реальних результатів: розв’язувати математичні задачі, виправляти помилки в коді, знаходити вразливості в програмному забезпеченні. Вони дійсно хочуть створити ШІ, які перемагають, які зберігаються, які обходять перешкоди. Якщо ви наймаєте когось, ви хочете старанного та рішучого співробітника, а не того, хто здається, щойно стикається з перешкодою.
Ці компанії докладають набагато більше зусиль, щоб зробити своїх ШІ ефективними в перемозі, ніж щоб вони дбали про нас. І це також легше зробити їх ефективними в перемозі, ніж у тому, щоб вони по суті дбали про нас. Як виглядає турбота про людей? Я не знаю. Але правильне розв’язання математичної задачі — це те, що можна перевірити. І тому вони будуть набагато кращими в отриманні правильної відповіді за будь-яку ціну, ніж у по суті дбайливому ставленні до нас.
Що, на вашу думку, є найважливішим і найчіткішим висновком з вашої майбутньої книги, який ви хотіли б донести до громадськості?
Однією з ключових ідей, що рухає книгу, є те, що штучний загальний інтелект (AGI) насправді стане універсальною машиною для заміщення праці. Люди часто розглядають ШІ або як екзистенційний ризик, або як загрозу робочим місцям чи інші більш прозаїчні проблеми, не бачачи зв’язку між цими речами. Але для мене здатність заміщувати працю в усіх сферах також є тим, що робить ШІ екзистенційним ризиком.
Люди, що займаються безпекою ШІ, надзвичайно зосереджені на екзистенційному ризику, суперінтелекті та рекурсивному самовдосконаленні. Але більшість людей насправді не вірять у це або не думають про це. Більшість людей будуть задоволені зупинкою значно раніше, ніж дійде до загрози вимирання та суперінтелекту. Вони просто не хочуть, щоб їхню роботу забрала машина. Світ явно не готовий до того, щоб усі робочі місця, що вимагають інтелектуальної праці та можуть виконуватися віддалено, зникли за кілька років. Це переверне суспільство догори дриґом.
Я вважаю, що спільнота безпеки ШІ робить величезну помилку, надмірно ускладнюючи ситуацію. Багатьом людям у цій сфері не так вже й сильно заважає питання робочих місць. Вони думають: “О, хіба не було б чудово, якби всі могли жити в достатку і не працювати?” І це звучить привабливо, але чи справді ми отримаємо такий світ? Чи довіряєте ви нинішній владі відповідально провести нас через це? Я — ні.
Якщо почати з зупинки розробки передових ШІ-систем як вашої головної мети, що, на мою думку, ми повинні прагнути, тоді люди, стурбовані ризиками, зможуть приєднатися. Люди, стурбовані робочими місцями, довкіллям, стеженням, концентрацією влади та багатства — всі вони можуть приєднатися, не вимагаючи згоди щодо причин, з яких вони це роблять. Я вважаю, що спільнота безпеки ШІ довгий час зосереджувалася на тому, щоб змусити людей перейматися тим, що їх хвилює, з тих самих причин. І вони уникали більш сміливої позиції щодо простого припинення передової розробки.
Я лівих поглядів, і мене турбувало те, що ліві сили не усвідомлювали, наскільки далеко зайшла технологія і що можливо, якщо вона продовжить розвиватися. Я думаю, це пов’язано з запереченням можливостей ШІ. Тому книга намагається дати чесний погляд на ці можливості та сказати: “Дивіться, я насправді переймаюся тим, що вас хвилює. [ШІ-компанії] не просто роздувають ці речі. Є певний хайп, безперечно є брехня, але ми не готові до того, що насувається”. Навіть якщо ми не віримо, що вони досягнуть усього, до чого прагнуть, їм навіть не слід дозволяти намагатися. Це неприйнятно з демократичної точки зору.
Ви описуєте AGI як “машину, що робить все застарілим”, що означає, що вона прагне замінити все, що може зробити людський розум. Як ви проводите межу між звичайною технологією, що заощаджує працю і покращує життя, і технологією, яка заходить занадто далеко? Чи є принциповий спосіб розрізнити швейні машини, що зменшують попит на робочу силу в швейній промисловості, та ШІ, що замінює роботу письменників, подібних до нас?
Це одне з найскладніших питань.
Корі Доктороу має книгу “The Reverse Centaur’s Guide to Life After AI”, де він уявляє нас у майбутньому, керованому ШІ, як “зворотного кентавра”, де ШІ — це голова, а люди — ноги. ШІ виконує цікаву роботу, а людина існує лише для заповнення прогалин — по суті, як асистент ШІ.
Багато художників та ілюстраторів отримують від клієнта зображення, згенеровані ШІ, а потім їм кажуть: “Чи не могли б ви доопрацювати це ось так або змінити те й інше?” І вони стають більш відчуженими від роботи. Вони не обов’язково отримують вигоду від ефективності [технології]. Вони, скоріше, просто стискаються.
Моя загальна позиція полягає в тому, що ми не повинні намагатися створювати системи, які можуть замінити всю людську працю без згоди та безпеки, але можливо створювати інструменти, які можуть автоматизувати окремі завдання. Дослідники з Google DeepMind розв’язали проблему згортання білків, створивши AlphaFold. Раніше для визначення того, як згортається один білок, потрібно було витратити $100 000 і, можливо, час цілого аспіранта. І я думаю, дослідники, які цим займаються, кажуть: “Дякую, це чудово. Ми не хотіли цим займатися. Тепер ми можемо зосередитися на інших, більш цікавих частинах проблеми”. Це ідеальний приклад бажаної форми автоматизації.
У мене немає надто чіткої відповіді, але я вважаю, що ми краще зробимо, якщо підійдемо до цього більш цілеспрямовано та продумано, ніж зараз, коли ми створюємо машини, які можуть виконувати якомога більше роботи, якомога швидше, а потім викидаємо їх у світ.
Мені здається, я отримую меседж, що безпека ШІ — це найважливіше питання у світі зараз, і якщо ми не розберемося з ним правильно, то ніщо інше не матиме значення. Чи вважаєте ви, що це точно? Де це залишає інші важливі світові проблеми?
Можливо, нам залишаються роки, а можливо, навіть місяці — я не думаю, що це буде так швидко, хоча деякі люди так вважають — до рекурсивного самовдосконалення, до штучного загального інтелекту. Правильне або неправильне вирішення цього питання може перекрити всі інші рішення. Якщо ви зробите це дуже неправильно, ви можете досягти людського вимирання і більше не матимете шансів покращити ситуацію для будь-кого. Якщо ви зробите це правильно, тоді, можливо, все, що залишиться, — це переконатися, що перші надлюдські машини будуть дійсно спрямовані на глибоке піклування про всіх людей і всіх тварин, і зроблять світ кращим для всіх.
Також є той факт, що [філантропічні] кошти спрямовуються на безпеку ШІ, тому що люди, які працювали в цій сфері раніше, тепер мають величезні статки. Те, що їх хвилює, буде переважати. Багато з цих людей дійсно турбуються про добробут тварин і глобальну бідність, і ми бачимо більше коштів на всі ефективні альтруїстичні причини загалом. Але я вважаю, що ризиковано говорити: “Ця одна річ має таке велике значення” через таке, ніби “судний день” міркування.
Безпека ШІ зараз отримує величезну філантропічну увагу. Чи варто нам турбуватися, що це може відволікти ресурси від інших важливих, недостатньо висвітлених проблем — глобальної бідності, промислового тваринництва тощо?
Я вважаю, що це завжди повинно викликати занепокоєння. І багато грошей та зусиль було витрачено на аспекти безпеки ШІ, які, на мою думку, не є надто корисними. Я досить скептично ставлюся до технічних досліджень з узгодження як до напрямку для інвестування коштів, тому що якщо ви розв’яжете проблему узгодження — коли ви можете змусити надлюдські машини робити те, що ви хочете — це насправді не розв’язує проблему.
Дослідження з узгодження були основним напрямком філантропічного фінансування безпеки ШІ. Базова ідея полягає в наступному: важко змусити машини робити те, що ви хочете. Оскільки вони стають потужнішими та автономнішими, вони поводяться більш непередбачувано. І також важко знати, чого саме ви повинні хотіти — які цінності ви повинні намагатися вкласти в машини. Чи це виконання того, що хоче розробник, чи те, що хоче користувач, чи якась комбінація? Якщо ви насправді розв’яжете проблему узгодження, тобто зможете змусити надзвичайно розумну машину робити все, що хоче розробник або користувач, тоді у вас все одно залишаться проблеми: витіснення робочих місць, концентрація влади та багатства, використання енергії. У вас все одно залишиться проблема, що Стівен Міллер матиме доступ до суперінтелекту, і він робитиме те, що він хоче.
У сфері безпеки ШІ були дуже недостатньо висвітлені аспекти, такі як побудова руху — реальний масовий рух проти цієї технології. А також перевірка міжнародних угод — вам потрібно буде перевіряти, чи дотримуються умови будь-якої угоди, і це складно.
Інший напрямок, який міг би фінансуватися, — це дослідження того, що насправді станеться з економікою, якщо ми зупинимо або призупинимо розробку передових ШІ-систем. Якби ми намагалися призупинити розробку, Nvidia заявила б Трампу, що це зруйнує економіку. Було б досить корисно провести реальний аналіз серйозним економістом, який би показав, які будуть наслідки, але як ми можемо їх пом’якшити. Як би виглядали призупинення та певна монетарна або фіскальна політика для компенсації економічних наслідків?
Отже, для мене проблема полягає не стільки в тому, що безпека ШІ отримала так багато грошей і уваги, скільки в тому, що вони були спрямовані на речі, які не є найефективнішими.
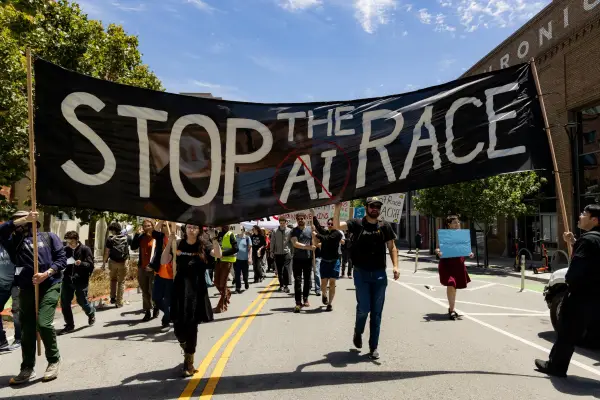
Ви говорите про побудову руху. Чи це те, що ви хотіли б бачити, — справжній масовий рух, щоб зупинити передовий ШІ і спрямувати нас на кардинально інший курс?
Коли я працював над книгою, це завжди був мій план — щоб вона стала закликом до дії для людей. Стало цілком зрозуміло, що це єдиний противага надмірній владі уряду чи індустрії.
Я не дуже довіряю уряду чи індустрії, що вони правильно впораються з цим, тому що спокуса [створювати потужні ШІ] дуже сильна. Але переважна більшість людей не отримає вигоди від знецінення їхньої робочої сили та від того, що ці компанії стануть безпрецедентно багатими та могутніми. Однією з головних відсутніх речей є чіткий заклик, який є простим і привабливим для багатьох людей. Зупинити гонку зі заміщення нас — зупинити створення універсальних машин для заміщення праці — це насправді те, що люди можуть підтримати.
Я вважаю, що нам просто потрібно діяти швидко. Той факт, що громадськість усвідомлює це, дуже обнадіює. Нам не потрібно винаходити велосипед. Нам просто потрібні чіткі вимоги та масові рухи, організації, що базуються на конкретних проблемах, які значно вплинули на світ у минулому.
Подробиці можна знайти на сайті: www.vox.com